
Inhaltsverzeichnis
- PostgreSQL Connections: Warum jede Verbindung teuer ist
- Das Problem in Kubernetes: HPA und Connection Explosion
- Architecture Deep Dive: Application-Side vs. Server-Side Pooling
- Kubernetes Deployment-Strategien im Vergleich
- Praxistest: Nativer psycopg-pool in Django 5.1
- Die Lösung: Zentraler PgBouncer im Kubernetes-Cluster
- Produktionsergebnisse: 85 % weniger Datenbankverbindungen
- Wichtige technische Einschränkungen im Transaction Mode
- Entscheidungsmatrix: Welcher Pooling-Ansatz passt zu deinem Projekt?
- Fazit: Der richtige Connection-Pool für deine Architektur
- Häufig gestellte Fragen (FAQ)
Über den Autor

03.11.2026
PostgreSQL-Verbindungen in Kubernetes skalierenDjango Database Connection Pooling: PgBouncer vs. Django 5.1
Django 5.1 bringt natives Connection Pooling mit – doch in Kubernetes stößt es mit steigender Zahl an Pods an Grenzen. Wir zeigen, wie PgBouncer PostgreSQL-Verbindungen global bündelt und sie in einem realen Produktionsprojekt um bis zu 85 % reduziert hat.
Vorausgesetzte Kenntnisse
Folgende Kenntnisse solltest du haben, um den Artikel ideal zu nutzen:- Django-Architektur: Konfiguration von
DATABASES,CONN_MAX_AGEund Datenbanktreiber wiepsycopg(v3). - PostgreSQL-Interna: Das Process-per-Connection-Modell (
fork()), Shared Memory,max_connectionsund Ressourcen-Overhead. - Kubernetes-Betrieb: Pod-Lifecycle, Horizontal Pod Autoscaling (HPA), K8s Services und Microservices.
- Connection-Pooling-Theorie: Unterschied zwischen Application-Side Pooling (In-Memory) und Server-Side Reverse Proxies (PgBouncer).
Fragen oder Feedback zur Architektur? Nutze gerne die Kommentarfunktion am Ende des Beitrags oder kontaktiere unser Team für Cloud-Native Entwicklung.
Wer eine skalierbare Python-Webanwendung auf Kubernetes betreibt, stößt früher oder später an ein fundamentales Nadelöhr: die maximale Anzahl paralleler Datenbankverbindungen.
In kleineren Setups mit einer Handvoll fixer Anwendungs-Server fällt das Problem selten auf. Wer jedoch auf eine containerisierte Microservice-Architektur setzt, bei der Dutzende Pods dynamisch nach oben und unten skaliert werden, bringt PostgreSQL überraschend schnell an seine Leistungsgrenzen.
Mit Django 5.1 wurde lang ersehntes natives Connection Pooling auf Basis von psycopg-pool eingeführt. Doch in containerisierten Cluster-Umgebungen entpuppt sich dieses Feature oft als trügerische Scheinlösung. In diesem Leitfaden analysieren wir, warum PostgreSQL-Connections architektonisch so teuer sind, warum In-App-Pooling unter Kubernetes-Autoskalierung versagt und wie wir bei Blueshoe als Python- und Django-Agentur durch den gezielten Einsatz von PgBouncer unsere Datenbankverbindungen in Production um bis zu 85 % senken konnten.
PostgreSQL Connections: Warum jede Verbindung teuer ist
Um zu verstehen, warum Verbindungsprobleme unter Last auftreten, lohnt ein Blick in die Prozessarchitektur von PostgreSQL.
Das Process-per-Connection-Modell
Im Gegensatz zu Datenbanken wie MySQL oder Microsoft SQL Server, die auf leichtgewichtige Worker-Threads setzen, arbeitet PostgreSQL historisch bedingt mit einem Process-per-Connection-Modell. Das bedeutet: Für jede einzelne eingehende TCP-Verbindung eines Clients forkt der PostgreSQL-Masterprozess einen komplett eigenständigen Betriebssystem-Prozess (postgres: worker).
+-------------------------------------------------------------+
|                      PostgreSQL Host                        |
|                                                             |
|  +--------------------+  +--------------------+             |
|  | Main Postgres Proc |  | Shared Buffer Pool |             |
|  +---------+----------+  +---------+----------+             |
|            |                       |                        |
|            | fork()                | Shared Memory          |
|            v                       v                        |
|  +--------------------------------------------+             |
|  | Backend Process #1  (RAM & CPU Overhead)   |             |
|  +--------------------------------------------+             |
|  | Backend Process #2  (RAM & CPU Overhead)   |             |
|  +--------------------------------------------+             |
|  | ... Backend Process #N                     |             |
+-------------------------------------------------------------+
Jeder dieser Backend-Prozesse bringt messbare Kosten mit sich:
- OS-Overhead: Die Ausführung von
fork()auf Betriebssystem-Ebene ist CPU-intensiv. - Speicherverbrauch: Pro Verbindung alloziiert PostgreSQL dedizierten Arbeitsspeicher – typischerweise 2 bis 10 MB RAM Basiskosten plus session-spezifisches
work_memfür Sortierungen und Hash-Joins. - Verbindungsaufbau: TCP-Handshake, TLS/SSL-Verschlüsselung, Passwort-Authentifizierung und das Setzen von Session-Parametern (
TimeZone,search_path) kosten Latenz. - Context Switching: Bei 200 bis 500 aktiven OS-Prozessen verbringt der Kernel einen erheblichen Teil der Rechenzeit mit dem Umschalten zwischen Prozessen (Context Swapping), statt SQL-Queries abzuarbeiten.
Die Folge: Selbst wenn hunderte Verbindungen völlig untätig sind (idle in transaction oder idle waiting for query), belegen sie wertvollen Arbeitsspeicher und belasten den Scheduler der Datenbankmaschine.
Das Problem in Kubernetes: HPA und Connection Explosion
In Kubernetes verschärft sich dieses Verhalten exponentiell durch das Zusammenspiel von Pod-Replikation und dem Horizontal Pod Autoscaler (HPA).
In unseren Projekten setzen wir als performanten Application Server auf django-hurricane, um Django-Anwendungen mit nativer Cloud-native Unterstützung im Cluster zu betreiben (siehe auch unseren Beitrag zu Django Hurricane auf Kubernetes). Bei Lastspitzen skaliert Kubernetes die Pods dynamisch nach oben.
Ohne zentralen Connection Pool hält jeder Pod bzw. ASGI/WSGI-Worker seine eigenen TCP-Verbindungen zur Datenbank. Schauen wir uns die Kennzahlen aus einem unserer realen Kundenprojekte vor der Optimierung an:
- E-Commerce Webshop: Verschiedene Microservices verteilt auf 18 Pods / Replicas
- Website-Portal: Redaktions- und Content-Service verteilt auf 3 Pods / Replicas
Die Messwerte in unserer Produktionsumgebung:
- Webshop-Datenbank: Konstant bei ~120 aktiven Verbindungen
- Website-Datenbank: Konstant bei ~35 aktiven Verbindungen
Sobald der HPA bei einer Marketing-Kampagne oder saisonalem Traffic weitere Pods startete, drohte die PostgreSQL-Instanz an das Limit max_connections zu stoßen oder durch den massenhaften Verbindungsaufbau in Timeouts zu laufen.
Architecture Deep Dive: Application-Side vs. Server-Side Pooling
Um die richtige Skalierungsstrategie zu wählen, muss man zwischen zwei grundlegenden Pooling-Mustern unterscheiden:
A) Application-Side Pooling (Django 5.1 / psycopg-pool)
+-----------------------+     +-----------------------+
|  Pod 1                |     |  Pod 2                |
|  +-----------------+  |     |  +-----------------+  |
|  | psycopg-pool    |  |     |  | psycopg-pool    |  |
|  | (Local Pool)    |  |     |  | (Local Pool)    |  |
|  +--------+--------+  |     |  +--------+--------+  |
+-----------|-----------+     +-----------|-----------+
            | (5 Connections)             | (5 Connections)
            +--------------+--------------+
                           v
              +-------------------------+
              |      PostgreSQL DB      |
              | (Total: 10 Connections) |
              +-------------------------+

-------------------------------------------------------

B) External Pooling (PgBouncer)
+-----------------------+     +-----------------------+
|  Pod 1                |     |  Pod 2                |
|  (Short-lived /       |     |  (Short-lived /       |
|   Transient Conns)    |     |   Transient Conns)    |
+-----------+-----------+     +-----------+-----------+
            |                             |
            +--------------+--------------+
                           v
              +-------------------------+
              |    Central PgBouncer    |
              |    (Transaction Pool)   |
              +------------+------------+
                           | (2 Connections)
                           v
              +-------------------------+
              |      PostgreSQL DB      |
              | (Total: 2 Connections)  |
              +-------------------------+
Muster A: Application-Side Pooling (Django 5.1 mit psycopg-pool)
Das Pooling findet im Arbeitsspeicher des Python-Prozesses statt. Der Anwendungscode bedient sich aus einem lokalen Reservoir an vorab aufgebauten Datenbankverbindungen.
- Vorteile: Kein zusätzlicher Infrastruktur-Dienst nötig; minimale Latenz zwischen Python-Code und lokalem Pool.
- Nachteile: Der Pool ist isolationistisch. Jeder einzelne Pod verwaltet seinen eigenen Pool, völlig ohne Kenntnis über die restlichen Pods oder die Gesamtkapazität der Datenbank.
Muster B: Server-Side / External Pooling (PgBouncer)
Zwischen den Django-Pods und der PostgreSQL-Datenbank schaltet sich ein schlanker, hochperformanter TCP-Proxy.
- Vorteile: Hunderte oder tausende Client-Verbindungen aus beliebig vielen Pods werden auf eine minimale Anzahl echter PostgreSQL-Backend-Prozesse multiplexed (Connection Multiplexing).
- Nachteile: Ein minimaler zusätzlicher Network-Hop; Einschränkungen bei bestimmten PostgreSQL-Session-Features (z. B. Named Cursors und Prepared Statements im Transaction Mode).
Kubernetes Deployment-Strategien im Vergleich
Für den Einsatz in Kubernetes stehen Teams vor drei architektonischen Wegen:
| Strategie | Architektur | Vorteile | Nachteile | Eignung |
|---|---|---|---|---|
| 1. Nur natives Django 5.1 Pooling | Pod → Postgres | Keine zusätzliche Infrastruktur, Konfiguration rein über settings.py. | Kein globales Pooling; Connection-Zahl skaliert linear mit Pods; Risiko von Connection Explosions. | Monolithen auf VMs oder statische Setups mit maximal 2–3 Pods. |
| 2. PgBouncer als Sidecar-Container | Pod (App + PgBouncer) → Postgres | Klare Kapselung pro Pod; Traffic bleibt über localhost lokal. | Immer noch kein globales Pooling über Microservices hinweg; jeder Pod belegt DB-Verbindungen. | Wenn Pods isoliert deployt werden und Netzwerklatenz minimiert werden muss. |
| 3. Zentraler PgBouncer Service | Pods → PgBouncer Cluster → Postgres | Maximaler Multiplexing-Effekt; deckelt die Gesamtverbindungen an der Datenbank zuverlässig. | Eigene Komponente im Cluster; muss bei Hochverfügbarkeit (HA) redundant ausgelegt werden. | Standard-Empfehlung für Kubernetes, Microservices und HPA-Setups. |
Praxistest: Nativer psycopg-pool in Django 5.1
Mit dem Release von Django 5.1 wurde Unterstützung für das integrierte Pooling des modernen psycopg (v3) Treibers hinzugefügt. Das Feature benötigt das Zusatzpaket psycopg[pool] und lässt sich direkt in den Django-Datenbankeinstellungen aktivieren:
# settings.py (Django 5.1+ mit psycopg v3)

DATABASES = {
    "default": {
        "ENGINE": "django.db.backends.postgresql",
        "NAME": "webshop_db",
        "USER": "django_user",
        "PASSWORD": "secretpassword",
        "HOST": "postgres-service",
        "PORT": "5432",
        "OPTIONS": {
            "pool": {
                "min_size": 2,
                "max_size": 4,
                "timeout": 10,
            }
        },
    }
}
Unsere Produktions-Ergebnisse mit nativem Pooling
Wir haben das Feature unter realen Lastbedingungen an einem unserer Webshop-Services auf Herz und Nieren getestet. Das Ergebnis war ernüchternd:
- Default-Einstellungen führten zu Request-Crashes:
Mit den Standardwerten lief der Service unter Spitzenlast sofort in Timeouts:django.db.utils.OperationalError: couldn't get a connection after 10 seconds - Feintuning brachte keine globale Entlastung:
Nach Erhöhung vonmax_sizeundtimeoutstabilisierte sich der einzelne Pod zwar, die Gesamtzahl der offenen Verbindungen an der PostgreSQL-Datenbank sank jedoch nicht. - Connection Explosion beim HPA-Rollout:
Als das Feature auf alle 18 Replicas der Webshop-Architektur ausgerollt wurde, stieg die Zahl der offenen Verbindungen an der Datenbank sogar noch an.
Warum scheitert Application-Side Pooling in Kubernetes?
Die Ursache liegt in der einfachen Multiplikationslogik:
Offene Verbindungen = Anzahl Pods × Worker pro Pod ×
min_size
Wenn 18 Pods mit jeweils 4 Workern einen lokalen Pool mit min_size = 2 und max_size = 6 öffnen, hält das System im Leerlauf bereits 18 × 4 × 2 = 144 Verbindungen dauerhaft blockiert. Skaliert der HPA auf 30 Pods, explodiert die Zahl auf bis zu 720 Verbindungen (30 * 4 * 6). Anstatt Verbindungen zu sparen, schafft man ein künstliches, starres Verbindungsplateau.
Erkenntnis für Kubernetes-Architekten: Für Multi-Pod- und Microservice-Architekturen ist In-App-Pooling strukturell ungeeignet. Echtes Pooling erfordert eine zentrale Instanz, die Verbindungen über alle Pods hinweg aggregiert.
Die Lösung: Zentraler PgBouncer im Kubernetes-Cluster
Um ein echtes, clusterweites Multiplexing zu erreichen, haben wir einen zentralen PgBouncer im Transaction-Pooling-Modus implementiert.
In unserem Projekt setzen wir auf den Zalando Postgres-Operator, der PostgreSQL direkt im Kubernetes-Cluster betreibt und verwaltet. Der Operator bietet erstklassige native Unterstützung für PgBouncer.
1. Deklaration im Zalando Postgres-Operator
Das Aktivieren von PgBouncer erfolgt deklarativ über die postgresql-CRD:
apiVersion: "acid.zalan.do/v1"
kind: postgresql
metadata:
  name: webshop-db-cluster
spec:
  teamId: "blueshoe"
  volume:
    size: 50Gi
  numberOfInstances: 2
  users:
    webshop_user: []
  databases:
    webshop_db: webshop_user
  preparedDatabases:
    webshop_db: {}

  # PgBouncer aktivieren:
  enableConnectionPooler: true
  connectionPooler:
    numberOfInstances: 2       # Hochverfügbar ausgelegt
    mode: transaction          # Maximaler Multiplexing-Effekt
    resources:
      requests:
        cpu: 200m
        memory: 128Mi
      limits:
        cpu: 500m
        memory: 256Mi
Der Operator generiert automatisch ein Kubernetes-Service-Objekt (z. B. webshop-db-cluster-pooler), über das die Django-Pods den Pooler transparent ansprechen können.
2. Die entscheidenden Django-Einstellungen ("Gotchas")
Wer Django an einen PgBouncer im Transaction Pooling anbindet, muss neben dem Anpassen des HOST-Settings zwei zwingende Konfigurationen vornehmen:
# settings.py - Django-Konfiguration für PgBouncer Transaction Pooling

DATABASES = {
    "default": {
        "ENGINE": "django.db.backends.postgresql",
        "NAME": "webshop_db",
        "USER": "webshop_user",
        "PASSWORD": "secretpassword",
        # Verbindung geht auf den PgBouncer K8s Service:
        "HOST": "webshop-db-cluster-pooler",
        "PORT": "5432",

        # GOTCHA 1: Standardmäßig hält Django persistente TCP-Verbindungen.
        # Im Transaction Pooling MUSS CONN_MAX_AGE auf 0 gesetzt werden!
        "CONN_MAX_AGE": 0,

        # GOTCHA 2: Server-Side Named Cursors erfordern eine feste DB-Session.
        # Für Transaction Pooling zwingend deaktivieren (ab Django 4.2+):
        "DISABLE_SERVER_SIDE_CURSORS": True,
    }
}
Warum CONN_MAX_AGE = 0 Pflicht ist
Standardmäßig versucht Django über CONN_MAX_AGE, Verbindungen über mehrere Requests hinweg offen zu halten. Beim Einsatz von PgBouncer führt das dazu, dass Django-Worker die Client-Slots von PgBouncer dauerhaft blockieren. Bei CONN_MAX_AGE = 0 öffnet und schließt Django die Verbindung zum PgBouncer pro Request. Da PgBouncer als lokaler Service im Cluster extrem latenzarm antwortet und die eigentlichen Server-Verbindungen zur Datenbank im Pool hält, ist dieser Overhead vernachlässigbar.
Warum DISABLE_SERVER_SIDE_CURSORS = True Pflicht ist
Django nutzt bei speicherintensiven Abfragen (etwa bei .iterator()) serverseitige Cursors (DECLARE name CURSOR FOR ...). Diese Cursors sind strikt an eine spezifische PostgreSQL-Session gebunden. Im Transaction-Pooling-Modus teilt PgBouncer jedem SQL-Statement bzw. jeder Transaktion eine beliebige freie Backend-Verbindung zu. Wechselt die Backend-Verbindung zwischen Statements, stürzt die Abfrage ab. DISABLE_SERVER_SIDE_CURSORS = True verhindert dieses Problem zuverlässig.
Produktionsergebnisse: 85 % weniger Datenbankverbindungen
Die Aktivierung von PgBouncer brachte eine dramatische Verbesserung in unseren Grafana- und Prometheus-Metriken. Verbindungs-Alerts gehörten sofort der Vergangenheit an:
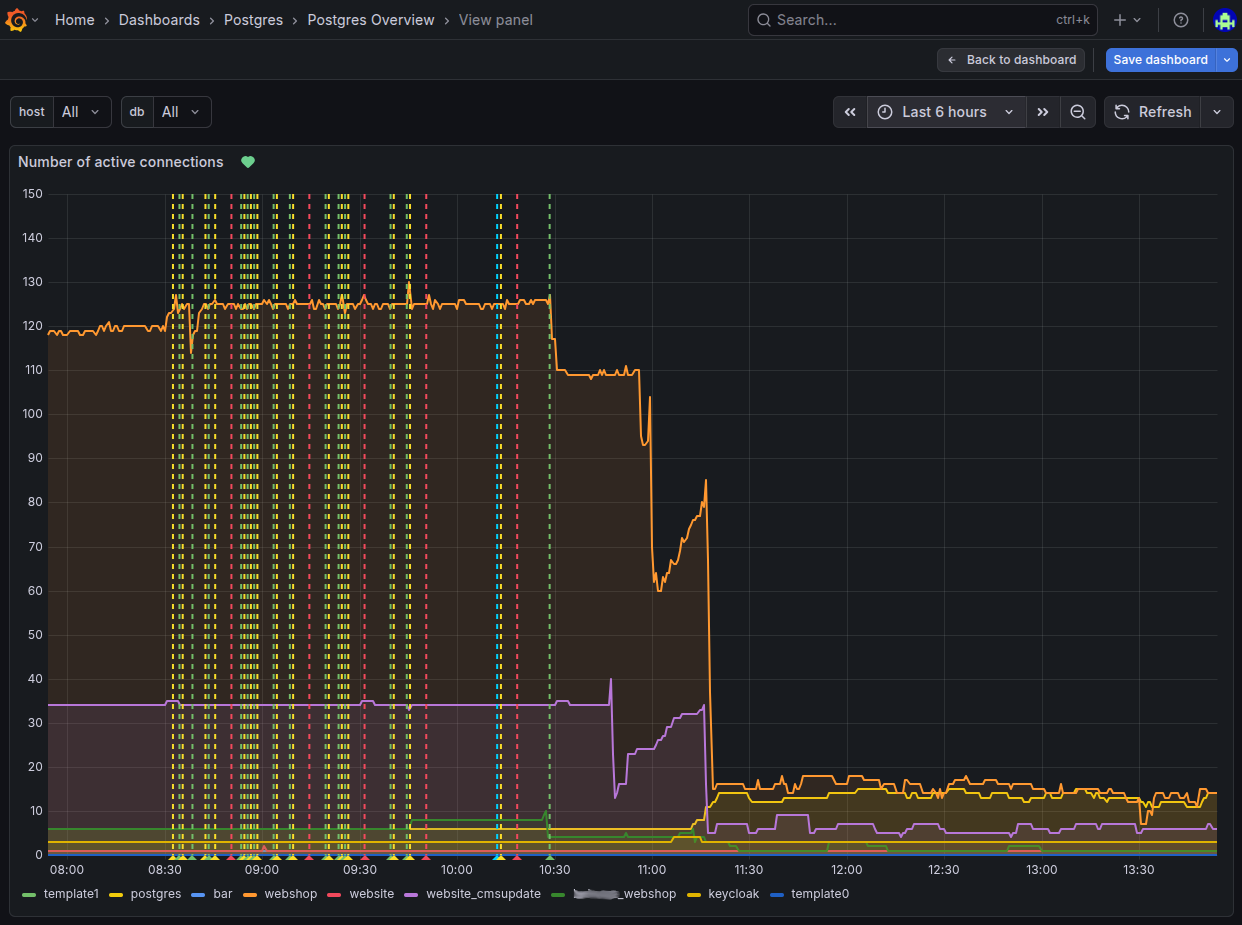
Reale Messwerte aus unseren Clustern
| Service / Umgebung | Pod-Anzahl | Verbindungen ohne PgBouncer | Verbindungen mit PgBouncer | Reduktion |
|---|---|---|---|---|
| Webshop DB (18 Replicas) | 18 Pods | ~120 aktive Verbindungen | 10 bis 20 Verbindungen | 83 – 91 % Reduktion |
| Website DB (3 Replicas) | 3 Pods | ~35 aktive Verbindungen | unter 10 Verbindungen | ~75 % Reduktion |
Trotz automatischer Skalierung der Pods durch HPA und stark schwankender Last blieb die Anzahl echter Datenbankverbindungen auf dem PostgreSQL-Server stabil im niedrigen zweistelligen Bereich.
Wichtige technische Einschränkungen im Transaction Mode
Transaction Pooling bietet den stärksten Multiplexing-Effekt, schränkt jedoch bestimmte PostgreSQL-Funktionen ein:
- Prepared Statements:
In älteren PgBouncer-Versionen funktionierten Prepared Statements im Transaction Mode nicht. Ab PgBouncer 1.21+ wird Protokoll-Level-Prepared-Statements unterstützt (max_prepared_statements > 0). In Django ist die Kombination mitDISABLE_SERVER_SIDE_CURSORS = Truejedoch weiterhin die sicherste Variante. LISTEN/NOTIFY:
Asynchrone Benachrichtigungskanäle in PostgreSQL sind fest an eine Session gekoppelt. Anwendungen, dieLISTEN/NOTIFYnutzen, müssen eine Direktverbindung zur Datenbank aufbauen oder einen separaten Session-Pool nutzen.- Django-Migrationen (
manage.py migrate):
Datenbankmigrationen führen DDL-Operationen, temporäre Tabellen und Locks aus (z. B.CREATE INDEX CONCURRENTLY). Best Practice: CI/CD-Pipelines sollten Migrationen immer direkt gegen den primären PostgreSQL-Port ausführen und PgBouncer umgehen. - Advisory Locks:
Session-Level Advisory Locks (pg_advisory_lock) funktionieren im Transaction Mode nicht zuverlässig. Nutze stattdessen Transaction-Level Locks (pg_advisory_xact_lock).
Entscheidungsmatrix: Welcher Pooling-Ansatz passt zu deinem Projekt?
                    Skalieren deine Django-Apps auf Kubernetes / HPA?
                                           |
                           +---------------+---------------+
                           |                               |
                          JA                              NEIN
                           |                               |
                           v                               v
               [ Zentraler PgBouncer ]             Monolithisches Setup
               - Transaction Pooling               auf fester VM / Server?
               - Perfekt für K8s & HPA                     |
                                           +---------------+---------------+
                                           |                               |
                                          JA                              NEIN
                                           |                               |
                                           v                               v
                               [ Django 5.1 psycopg-pool ]       [ PgBouncer Sidecar ]
                               - Minimaler Overhead              - Wenn Multi-Threaded
                               - Keine Zusatz-Infrastruktur      - Isolierte Pods
| Bewertungskriterium | Django 5.1 Native (psycopg-pool) | PgBouncer als Sidecar | Zentraler PgBouncer Cluster |
|---|---|---|---|
| Infrastruktur-Aufwand | Keiner (rein Python) | Gering (Container im Pod) | Mittel (eigener K8s Deployment/Operator) |
| Multiplexing-Effizienz | Gering (nur pro Prozess) | Mittel (nur pro Pod) | Maximal (global über alle Services) |
| HPA-Skalierbarkeit | Schlecht (Multiplikationseffekt) | Mäßig | Exzellent (deckelt DB-Last zuverlässig) |
| Feature-Kompatibilität | 100 % aller Postgres-Features | Nahezu 100 % (je nach Modus) | Hohe Kompatibilität bei richtiger Konfiguration |
Fazit: Der richtige Connection-Pool für deine Architektur
Der native psycopg-pool-Support in Django 5.1 ist ein wertvoller Schritt nach vorne für klassische Monolithen, Bare-Metal-Server oder virtuelle Maschinen. Er eliminiert den Bedarf an externer Software in kleinen bis mittleren Architekturen.
In dynamisch skalierenden Kubernetes- und Cloud-Native-Umgebungen stößt Application-Side Pooling jedoch an fundamentale architektonische Grenzen. Da jeder Pod isoliert agiert, führt Autoskalierung zwangsläufig zur Verbindungsüberlastung der PostgreSQL-Datenbank.
Wer Django im Cluster betreibt, kommt an einem zentralen PgBouncer kaum vorbei. Dank moderner Kubernetes-Operatoren wie dem Zalando Postgres-Operator ist das Setup mit minimalem Aufwand realisierbar – und das Ergebnis von bis zu 85 % weniger Datenbankverbindungen verschafft deiner Plattform die nötige Ausfallsicherheit für echtes Wachstum.
Möchtest du deine Datenbank- und Cloud-Architektur optimieren oder Hostingkosten nachhaltig reduzieren? Informiere dich über unsere Cloud-Infrastruktur-Beratung oder erfahre mehr über unsere Projekte in der Migration auf Kubernetes.
Häufig gestellte Fragen (FAQ)
Warum reicht das native Connection Pooling aus Django 5.1 in Kubernetes oft nicht aus?
Django 5.1 nutzt psycopg-pool auf Anwendungsebene innerhalb jedes einzelnen Python-Prozesses. Jeder Pod verwaltet seinen eigenen isolierten Pool. Bei horizontaler Autoskalierung (HPA) multipliziert sich die Mindestanzahl an Verbindungen mit jedem neuen Pod (Pods * min_size). Unter Last führt dies zu einer sogenannten Connection Explosion an der PostgreSQL-Datenbank, anstatt Ressourcen einzusparen.
Was ist der Unterschied zwischen persistenten Verbindungen (CONN_MAX_AGE) und echtem Connection Pooling?
CONN_MAX_AGE hält bestehende TCP-Verbindungen pro Thread bzw. Worker für eine definierte Zeitspanne offen, um wiederholte TLS- und TCP-Handshakes zu vermeiden. Echtes Connection Pooling (wie durch PgBouncer) verwaltet hingegen einen dynamischen Pool austauschbarer Server-Verbindungen und multiplexed hunderte eingehende Client-Anfragen auf wenige physische Datenbankprozesse.
Welcher Pooling-Modus von PgBouncer ist der beste für Django-Webanwendungen?
Für maximale Verbindungsreduktion wird Transaction Pooling empfohlen. Hierbei wird eine physische PostgreSQL-Verbindung nur für die exakte Dauer einer SQL-Transaktion zugewiesen und danach sofort für andere Pods freigegeben. Session Pooling bietet deutlich weniger Einsparpotenzial, während Statement Pooling mit Djangos Transaktionsmodell inkompatibel ist.
Warum muss CONN_MAX_AGE bei PgBouncer im Transaction-Mode auf 0 gesetzt werden?
Steht CONN_MAX_AGE auf einem Wert größer 0, hält Django die Verbindung zum PgBouncer offen. Das blockiert PgBouncer-Client-Slots und kann zu Session-State-Problemen führen. Bei CONN_MAX_AGE = 0 schließt Django die Verbindung nach dem Request sauber ab, während PgBouncer die echte Verbindung zur Datenbank im Pool weiterverwendet.
Warum muss DISABLE_SERVER_SIDE_CURSORS in Django mit PgBouncer auf True stehen?
Django verwendet bei Abfragen wie .iterator() standardmäßig serverseitige Cursors (Named Cursors). Diese setzen eine feste, zustandsbehaftete PostgreSQL-Session voraus. Im Transaction Pooling von PgBouncer kann die zugrundeliegende Backend-Verbindung zwischen SQL-Statements wechseln, was ohne DISABLE_SERVER_SIDE_CURSORS = True zu Query-Abstürzen führt.
Wie sollten Django-Migrationen (manage.py migrate) mit PgBouncer ausgeführt werden?
Datenbankmigrationen sollten PgBouncer im Transaction-Modus umgehen und direkt gegen die primäre PostgreSQL-Instanz (oder einen separaten Session-Pool) ausgeführt werden. Migrationen nutzen häufig DDL-Statements, Advisory Locks oder Schemaänderungen, die im Transaction Pooling nicht unterstützt werden.
Hast du noch Fragen oder eine Meinung? Mit deinem GitHub Account kannst Du es uns wissen lassen...
Hier sind ein paar Artikel, die du auch interessant finden könntest:



Was unsere Kunden über uns sagen


- Ofa Bamberg GmbHB2B Online-Shop | B2C Website | Hosting | Betreuung | Security
- Ludwig-Maximilians-Universität MünchenPlattformentwicklung | Hosting | Betreuung | APIs | Website
Blueshoe hat unsere Forschungsdatenplattform Munich Media Monitoring (M3) entwickelt und uns hervorragend dabei beraten. Das Team hat unsere Anforderungen genau verstanden und sich aktiv in die Ausgestaltung der Software und der Betriebsumgebung eingebracht. Wir sind froh, dass auch Wartung und weiterführender Support in Blueshoes Händen liegen.
- Deutsches MuseumDigitalisierung | Beratung | Datenbank-Optimierung | GraphQL | CMSFoto: Anne Göttlicher
Im Rahmen eines komplexen Digitalisierungsprojekts für unsere Exponate-Datenbank war Blueshoe ein äußerst verlässlicher Partner. Sie haben uns nicht nur während des gesamten Projekts hervorragend beraten, sondern unsere Anforderungen perfekt umgesetzt. Dank ihrer Arbeit ist unsere Datenbank nun ein bedeutender Mehrwert für die weltweite wissenschaftliche Forschung.
- Fonds Finanz Maklerservice GmbHPlattformentwicklung | Prozess-Systeme | Hosting | Betreuung | Zertifikate | Website© Fonds Finanz Maklerservice GmbH
Blueshoe ist unsere verlängerte Werkbank für Entwicklung, Wartung und Support unserer Weiterbildungs- und Zertifizierungsplattformen. Das Team hat sich gründlich in unsere Abläufe eingearbeitet, und wir freuen uns, Blueshoe als zuverlässigen Partner an unserer Seite zu haben.
- Technische Universität HamburgPlattformentwicklung | Beratung | Prozess-Systeme | Hosting | Website
Seit 2019 unterstützt uns die Blueshoe GmbH tatkräftig bei der Entwicklung und Weiterentwicklung des "Digital Learning Lab" und der "Digital Learning Tools". Dank ihrer Beratung konnten wir von Anfang an auf eine zukunftssichere, moderne technische Struktur setzen. Die Zusammenarbeit ist reibungslos, und wir fühlen uns rundum gut betreut. Und davon profitieren dann auch die Lehrkräfte in Hamburg.