
Inhaltsverzeichnis
- Was Django 6.0 tatsächlich mitbringt
- Ein Task in ein paar Zeilen
- Warum die gemeinsame Schnittstelle trotzdem hilft
- Was Celery weiterhin mitbringt
- Django Tasks und Celery im Vergleich
- Was würde ich für ein neues Projekt nehmen?
- Kann Celery hinter django.tasks laufen?
- Zwei Dinge bleiben bei jedem Backend wichtig
- Also, können wir Celery verabschieden?
Über den Autor

28.09.2026
Background Tasks in Django 6.0Django 6.0 Task Framework: Brauchen wir Celery noch?
Du möchtest nach der Registrierung eine E-Mail verschicken. Eigentlich eine überschaubare Anforderung. Ein bisschen später stehen Redis, ein zusätzlicher Worker und eine celery.py im Projekt. Dazu kommt die Frage, wer mitbekommt, wenn der Worker irgendwann keine Lust mehr hat. Willkommen bei Background Tasks.
Celery ist dafür seit Jahren eine naheliegende Wahl. Trotzdem muss das nicht für jedes Projekt der ganze Aufbau sein. Mit django.tasks hat Django 6.0 eine eigene Task-Schnittstelle bekommen. Da liegt der Gedanke nahe, Celery beim nächsten Update direkt mit auszubauen.
Damit würde ich noch warten.
Django 6.0 ist seit Dezember 2025 draußen. In den Release Notes siehst du, was wirklich mitgekommen ist. Und das unterscheidet sich an einer entscheidenden Stelle von der Vorstellung einer fertig eingebauten Task Queue.
Was Django 6.0 tatsächlich mitbringt
Mit django.tasks kannst du Aufgaben definieren und an ein Backend übergeben. Die Ausführung außerhalb des Requests übernimmt weiterhin zusätzliche Infrastruktur. Django selbst liefert dafür keinen produktiven Worker mit. Das habe ich erst einmal nachgelesen, weil ich genau das erwartet hätte.
Die beiden eingebauten Backends sind:
- ImmediateBackend: Führt die Aufgabe sofort aus. Der aufrufende Code wartet auf die Ausführung.
- DummyBackend: Hält eingereichte Aufgaben für Tests fest, führt sie aber nicht aus.
Ohne andere Konfiguration verwendet Django das ImmediateBackend. In der Tasks-Dokumentation steht das auch ziemlich deutlich: Ein Aufruf von .enqueue() bedeutet noch lange nicht, dass die Arbeit im Hintergrund läuft.
Das prüfe ich vor dem ersten Deployment. Sonst heißt die Funktion jetzt zwar Task, aber der Nutzer wartet weiterhin auf den Mailserver.
Und was ist mit dem DatabaseBackend?
Ich dachte zuerst auch an ein Backend, das Jobs über das Django ORM speichert. Im ursprünglichen Vorschlag war das tatsächlich vorgesehen. Zum ausgelieferten Umfang von Django 6.0 gehört es allerdings nicht. Die Backend-Referenz nennt nur Immediate und Dummy.
Ein Entwurf und ein Release sind eben zwei verschiedene Dinge. Für ein konkretes Setup zählt die Dokumentation der eingesetzten Version, nicht das, was im DEP mal stand.
Ein Task in ein paar Zeilen
Nehmen wir die Willkommensmail vom Anfang:
# notifications/tasks.py
from django.core.mail import send_mail
from django.tasks import task


@task
def send_welcome_email(email):
    return send_mail(
        subject="Schön, dass du dabei bist",
        message="Dein Account ist bereit. Du kannst loslegen.",
        from_email="hello@example.com",
        recipient_list=[email],
    )
Die Übergabe an das Backend sieht so aus:
send_welcome_email.enqueue("user@example.com")
Das Beispiel setzt ein konfiguriertes Django-Mailbackend voraus. Ob der Aufruf direkt arbeitet oder einen echten Hintergrundjob einreiht, bestimmt dein Task-Backend. Wenn du das wirklich asynchron willst, reicht der Decorator nicht. Dann brauchst du ein externes Backend mit Queue und Worker, so wie es Django beim Definieren und Einreihen beschreibt.
Bei Celery wäre derselbe Einstieg:
from celery import shared_task
from django.core.mail import send_mail


@shared_task
def send_welcome_email(email):
    return send_mail(
        subject="Schön, dass du dabei bist",
        message="Dein Account ist bereit. Du kannst loslegen.",
        from_email="hello@example.com",
        recipient_list=[email],
    )
send_welcome_email.delay("user@example.com")
Das zeigt jeweils die Task-Definition, kein vollständiges Deployment. In der Celery-Doku zu Tasks siehst du denselben Einstieg, plus Broker und Worker. Am Decorator allein macht die Entscheidung jedenfalls keinen Sinn.
Warum die gemeinsame Schnittstelle trotzdem hilft
Interessant wird das vor allem bei wiederverwendbaren Django-Apps. Eine App kann beschreiben, welche Arbeit ansteht. Das Projekt, das sie einsetzt, entscheidet über das passende Backend. Genau diese Trennung zwischen Aufgabe und Ausführung macht die Schnittstelle für solche Pakete brauchbar.
Ich denke, das passt gut zu Django. Bei einem Mailbackend erwarten wir schließlich auch, dass der Anwendungscode nicht jeden Transport selbst kennen muss. Im Beitrag zu django-o365 findest du ein verwandtes Prinzip.
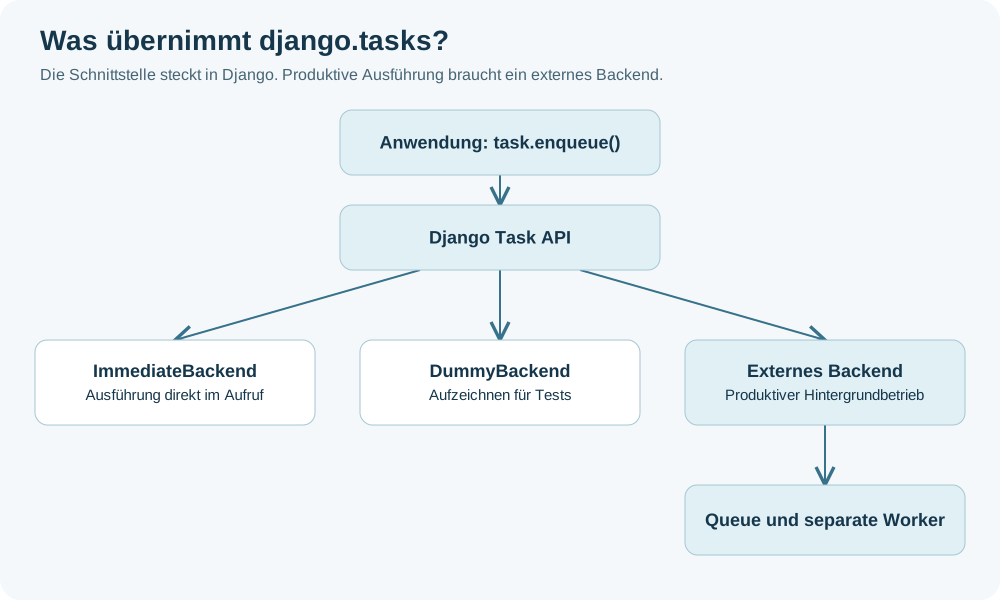
Django stellt die Schnittstelle bereit. Beim produktiven Backend kommen Queue und Worker dazu.
Ganz beliebig austauschbar werden Backends dadurch allerdings nicht. Prioritäten, verzögerte Ausführung und das spätere Abfragen von Ergebnissen hängen von den unterstützten Fähigkeiten ab. Dafür gibt es in der API Capability-Flags. Vor einem Wechsel lohnt sich da zuerst ein Blick.
Was Celery weiterhin mitbringt
Sobald Jobs voneinander abhängen oder Fehler gezielt behandelt werden müssen, werden die Unterschiede klarer.
Celery hat APIs für Retries, automatische Wiederholungen und Backoff. Außerdem gibt es beispielsweise Task Rate Limits. Da lohnt sich das Kleingedruckte in den Task-Optionen: Ein solches Limit gilt pro Worker-Instanz, nicht automatisch für die gesamte Installation.
Mit Canvas kannst du Abläufe zusammensetzen. Eine Chain führt Aufgaben nacheinander aus. Eine Group startet mehrere Aufgaben parallel. Ein Chord führt nach einer Gruppe einen weiteren Schritt aus, sofern das Result-Backend die Voraussetzungen erfüllt.
Stell dir einen Import aus mehreren Lieferantensystemen vor. Erst werden die Daten parallel abgeholt und verarbeitet, danach soll ein gemeinsamer Bericht entstehen. Da braucht es eine Antwort darauf, wann wirklich alles fertig ist und was bei einem Fehler passiert. Genau solche Fälle gehören nicht in django.tasks.
Für regelmäßige Aufgaben gibt es Celery Beat als Scheduler. Auch hier gehört Betrieb dazu: Mehrere Scheduler für denselben Zeitplan können dieselben Jobs mehrfach einreihen. Das habe ich in Setups schon gesehen, und es ist unangenehm still.
Für die Fehlersuche stehen unter anderem Inspection-Kommandos, Worker-Events und Flower zur Verfügung. Damit kannst du Worker und Aufgaben beobachten. Sinnvolle Alarme musst du trotzdem selbst festlegen.
Wenn ein Projekt diese Möglichkeiten bereits nutzt, steckt im Wechsel deutlich mehr Arbeit als das Austauschen eines Imports. Dann lohnt sich der Umstieg in der Regel nicht.
Django Tasks und Celery im Vergleich
| Frage | Django 6.0 Task Framework | Celery |
|---|---|---|
| Produktiver Worker enthalten? | Nein, kommt vom externen Backend | Ja, separat betreiben |
| Standard ohne weitere Task-Konfiguration? | Sofortige Ausführung im Aufruf | Für Hintergrundbetrieb Broker und Worker konfigurieren |
| Chains, Groups und Chords? | Keine entsprechende Workflow-API im Core | Über Canvas |
| Retries und Betriebsverhalten? | Vom gewählten Backend abhängig | Eigene APIs und Konfiguration |
| Monitoring? | Backend und eigene Integration prüfen | Inspection, Events, beispielsweise Flower |
| Skalierung? | Abhängig von Queue, Backend und Workern | Abhängig von Broker, Workern und Lastprofil |
Eine feste Aufteilung in „Django skaliert vertikal, Celery horizontal“ hilft hier nicht weiter. django.tasks legt das Produktionssystem gar nicht fest. Wie viele Worker du sinnvoll betreiben kannst, entscheidet die konkrete Implementierung, nicht das Framework-Label.
Was würde ich für ein neues Projekt nehmen?
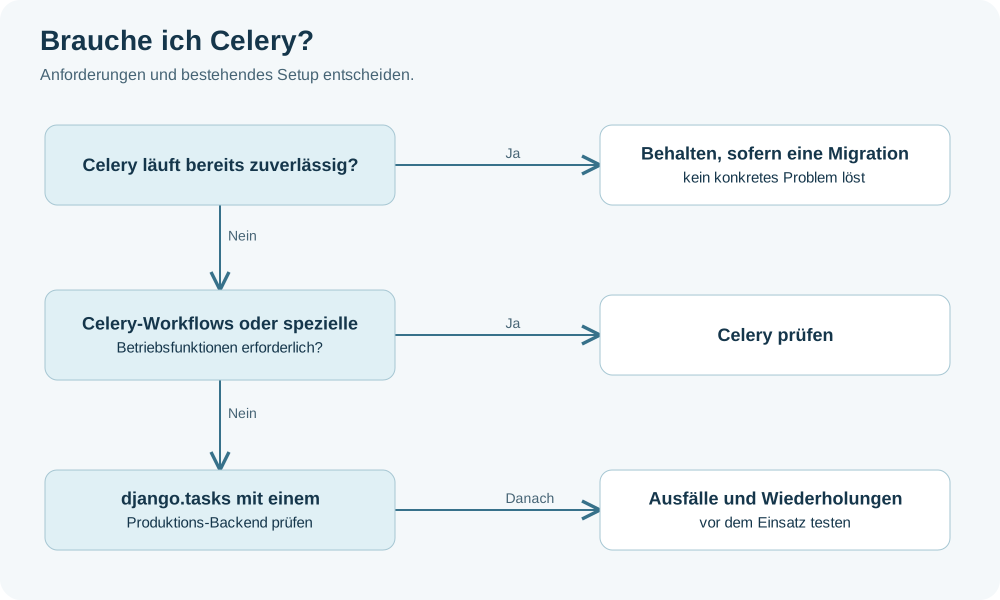
Bei wenigen unabhängigen Jobs lohnt sich django.tasks zusammen mit einem passenden Produktions-Backend. Zum Beispiel für Exporte oder Bildverarbeitung, bei denen keine komplizierten Abhängigkeiten zwischen Jobs bestehen.
Meine Fragen wären ziemlich bodenständig: Wo sehe ich fehlgeschlagene Aufgaben? Was passiert bei einem Worker-Absturz? Wie funktionieren Wiederholungen? Können wir das Setup vernünftig deployen und überwachen?
Bei einem bestehenden, gut laufenden Celery-Setup würde ich erst einmal dabei bleiben. Eine Migration sollte ein konkretes Problem lösen. „Ist jetzt im Framework“ reicht mir dafür nicht.
Wenn Chains, Chords oder spezielle Celery-Funktionen schon fest zur Anwendung gehören, sollte diese Abhängigkeit auch im Code sichtbar bleiben. Eine kleinere Schnittstelle davorzusetzen bringt wenig, wenn man dauernd daran vorbei arbeiten muss.
Weitere Optionen haben wir bereits im Beitrag Alternativen zu Celery für Django auf Kubernetes besprochen. Auch mit Django 6.0 lohnt sich da nochmal ein Blick, bevor Celery aus Gewohnheit aufgesetzt wird.
Kann Celery hinter django.tasks laufen?
Über die Backend-API ist ein Adapter zu Celery grundsätzlich denkbar. Daraus folgt aber nicht, dass Django einen solchen Adapter mitliefert oder dass bestehende Celery-Workflows automatisch darüber funktionieren. Die konkrete Integration muss diese Übersetzung übernehmen.
Vor einer Migration muss klar sein, welche Versionen und Funktionen ein Adapter unterstützt. Besonders bei Ergebnissen, Fehlern und Wiederholungen will ich wissen, welches Verhalten meine Anwendung bekommt.
Als ersten Kandidaten nehme ich einen unabhängigen Job. Dann Eingaben und Ergebnis vergleichen, Fehler provozieren und das Monitoring prüfen. Bestehende Queues müssen außerdem kontrolliert abgearbeitet werden. Zwei Implementierungen, die dieselbe Mail verschicken, sind selten das gewünschte Migrationsergebnis.
Zwei Dinge bleiben bei jedem Backend wichtig
Übergebe einfache Daten. Für Django Tasks müssen Argumente und Rückgabewerte JSON-kompatibel sein. Bei Datenbankobjekten gehört deshalb die ID in den Task. Der Worker lädt das Objekt selbst.
Beachte Transaktionen. Ein Worker kann loslaufen, bevor der neue Datensatz committed wurde. Django zeigt dafür transaction.on_commit(): Erst wenn die Transaktion erfolgreich abgeschlossen ist, wird die Aufgabe eingereiht. Das steht auch so in der Doku zu Tasks und Transaktionen. Das ist kein optionales Nice-to-have.
Auch danach bleibt eine praktische Frage: Was passiert, wenn der Commit erfolgreich war, aber die Übergabe an die Queue fehlschlägt? Bei geschäftskritischen Abläufen braucht es dafür ein Konzept. Ein Outbox-Verfahren mit separatem Dispatcher ist eine mögliche Lösung.
Und Jobs sollten Wiederholungen vertragen. Wenn ein externer Dienst eine Aktion ausgeführt hat, aber die Antwort unterwegs verloren geht, ist ein erneuter Versuch nicht automatisch harmlos. Das gilt beim Rechnungsversand genauso wie bei einer Zahlung.
Also, können wir Celery verabschieden?
Ich würde Celery noch keinen Abschiedsbrief schreiben.
Django 6.0 gibt uns einen gemeinsamen Einstieg für Background Tasks. Das ist vor allem dann interessant, wenn wir Aufgaben vom konkreten Ausführungssystem entkoppeln wollen. Welche Infrastruktur dahinter passt, müssen wir weiterhin anhand der Anwendung entscheiden.
Für neue Projekte mit einfachen, unabhängigen Background Jobs lohnt sich django.tasks. Eine passende Task Queue samt Worker brauchst du weiterhin. Wer Celery bereits sinnvoll einsetzt, hat durch Django 6.0 erst einmal keinen Grund, alles umzubauen.
Ich finde es gut, dass Django hier eine gemeinsame Grundlage schafft. Ob daraus am Ende weniger Aufwand wird, zeigt sich allerdings beim Betrieb. Ein anderer Decorator allein spart uns noch keinen Worker und löst auch keine fehlgeschlagenen Jobs.
Hast du noch Fragen oder eine Meinung? Mit deinem GitHub Account kannst Du es uns wissen lassen...
Hier sind ein paar Artikel, die du auch interessant finden könntest:


Was unsere Kunden über uns sagen


- Ofa Bamberg GmbHB2B Online-Shop | B2C Website | Hosting | Betreuung | Security
- Ludwig-Maximilians-Universität MünchenPlattformentwicklung | Hosting | Betreuung | APIs | Website
Blueshoe hat unsere Forschungsdatenplattform Munich Media Monitoring (M3) entwickelt und uns hervorragend dabei beraten. Das Team hat unsere Anforderungen genau verstanden und sich aktiv in die Ausgestaltung der Software und der Betriebsumgebung eingebracht. Wir sind froh, dass auch Wartung und weiterführender Support in Blueshoes Händen liegen.
- Deutsches MuseumDigitalisierung | Beratung | Datenbank-Optimierung | GraphQL | CMSFoto: Anne Göttlicher
Im Rahmen eines komplexen Digitalisierungsprojekts für unsere Exponate-Datenbank war Blueshoe ein äußerst verlässlicher Partner. Sie haben uns nicht nur während des gesamten Projekts hervorragend beraten, sondern unsere Anforderungen perfekt umgesetzt. Dank ihrer Arbeit ist unsere Datenbank nun ein bedeutender Mehrwert für die weltweite wissenschaftliche Forschung.
- Fonds Finanz Maklerservice GmbHPlattformentwicklung | Prozess-Systeme | Hosting | Betreuung | Zertifikate | Website© Fonds Finanz Maklerservice GmbH
Blueshoe ist unsere verlängerte Werkbank für Entwicklung, Wartung und Support unserer Weiterbildungs- und Zertifizierungsplattformen. Das Team hat sich gründlich in unsere Abläufe eingearbeitet, und wir freuen uns, Blueshoe als zuverlässigen Partner an unserer Seite zu haben.
- Technische Universität HamburgPlattformentwicklung | Beratung | Prozess-Systeme | Hosting | Website
Seit 2019 unterstützt uns die Blueshoe GmbH tatkräftig bei der Entwicklung und Weiterentwicklung des "Digital Learning Lab" und der "Digital Learning Tools". Dank ihrer Beratung konnten wir von Anfang an auf eine zukunftssichere, moderne technische Struktur setzen. Die Zusammenarbeit ist reibungslos, und wir fühlen uns rundum gut betreut. Und davon profitieren dann auch die Lehrkräfte in Hamburg.